
Trong bài viết này, Vbee AIVoice sẽ cùng bạn “mổ xẻ” cách hoạt động voice cloning theo cách dễ hiểu nhất: từ cơ chế trích xuất đặc trưng giọng nói, cách mô hình tạo ra câu mới, đến lý do tại sao chất lượng audio đầu vào lại quyết định trực tiếp tới sản phẩm âm thanh đầu ra.
1. 06 bước vận hành của mô hình nhân bản giọng nói
Để biến một bản thu âm mẫu thành một giọng AI có thể đọc văn bản mới, hệ thống nhân bản giọng nói phải trải qua một quy trình xử lý đa tầng. Dưới đây là luồng xử lý tổng quan từ dữ liệu âm thanh đến tệp đầu ra:
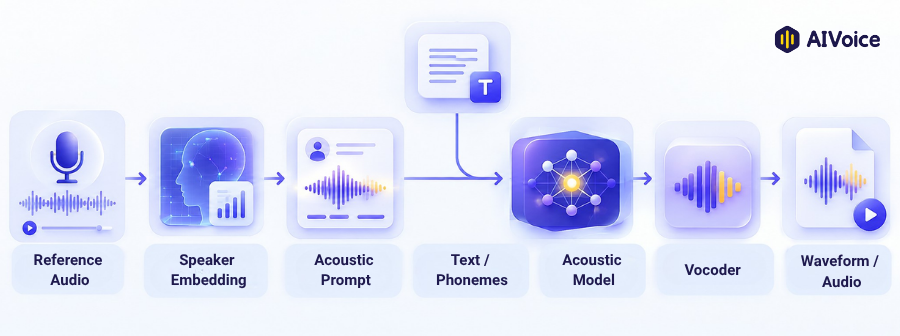
Để hiểu rõ voice cloning hoạt động như thế nào, chúng ta hãy phân tích chi tiết 6 bước vận hành cốt lõi theo quy trình trên:
Bước 1: Audio mẫu đầu vào (Reference Audio)
Hệ thống tiếp nhận tệp thu âm giọng nhân bản do người dùng cung cấp. Ở bước tiền xử lý, AI sẽ lọc bỏ một phần nhiễu nền cơ bản và cắt nhỏ tệp âm thanh thành các khung thời gian cực ngắn (vài miligiây) để phân tích dải tần số.
Bước 2: Trích xuất đặc trưng người nói – Speaker Embedding
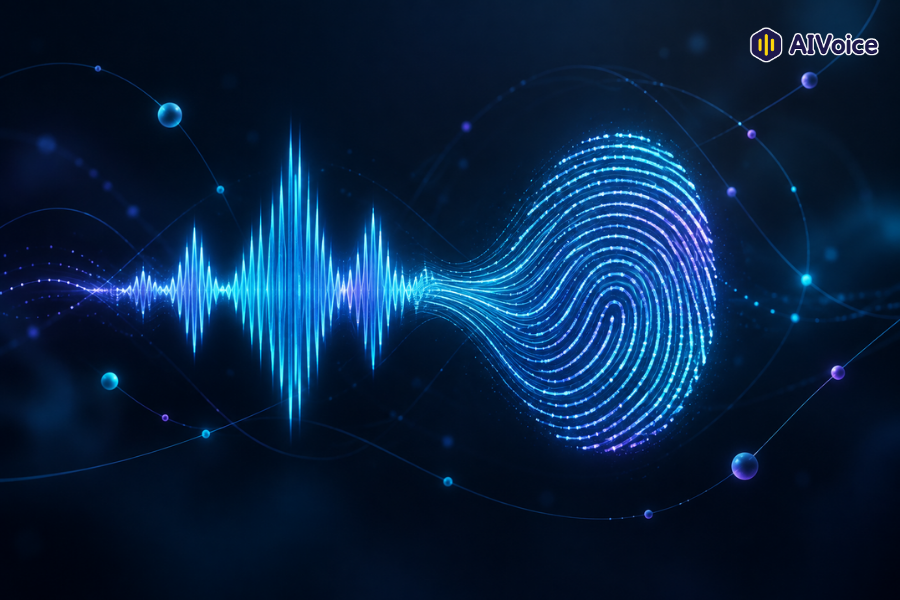
AI không “nhớ” giọng nói dưới dạng từ ngữ, mà chuyển đổi nó thành toán học.
- Speaker embedding là gì? Bạn có thể tưởng tượng speaker embedding chính là một “dấu vân tay giọng nói”. Đây là một chuỗi mã số hóa đại diện cho các thuộc tính vật lý duy nhất của bạn: độ trầm bổng (cao độ – pitch), độ dày/mỏng của âm sắc (timbre), độ vang và thói quen nhả chữ.
Bước 3: Biểu diễn giọng nói (Acoustic Prompt)
Hồ sơ âm thanh sau khi trích xuất sẽ được lưu trữ dưới dạng một “bản thiết kế âm thanh” (acoustic prompt). Bản thiết kế này đóng vai trò là kim chỉ nam, giúp mô hình AI ghi nhớ các thuộc tính giọng nói cần tuân thủ khi tạo câu thoại mới.
Bước 4: Kết hợp với Văn bản mới đầu vào
Khi bạn nhập một đoạn văn bản mới, hệ thống không đưa trực tiếp chữ viết vào bộ phát âm. Mô hình phân tích ngôn ngữ sẽ chuyển đổi chữ viết (graphemes) thành chuỗi các ký hiệu âm vị (phonemes) – tức cách mà từ đó thực sự được phát âm ra tiếng.
Bước 5: Mô hình tổng hợp giọng nói – Acoustic Model
Acoustic model có thể xem như “bộ não dịch thuật” của hệ thống. Nó nhận chuỗi âm vị từ văn bản bước 4, kết hợp với “dấu vân tay giọng nói” ở bước 3 để tính toán xem mỗi âm tiết nên được đọc kéo dài bao lâu, nhấn giọng ở đâu, cao độ thay đổi thế nào để câu đọc tự nhiên.
Bước 6: Bộ mã hóa âm thanh – Vocoder
Âm thanh đầu ra của Acoustic Model vẫn chỉ là các thông số đặc trưng phổ âm (mel-spectrogram).
- Vocoder là gì? Vocoder đóng vai trò như “bộ thanh quản kỹ thuật số”. Nó tiếp nhận các thông số phổ âm phẳng và chuyển đổi chúng thành các dải sóng âm thực tế (Waveform/Audio) với tần số chuẩn (như 24kHz hoặc 48kHz) mà tai người có thể nghe được qua loa hoặc tai nghe.
Lưu ý kỹ thuật: Kiến trúc phân tách giữa Speaker Encoder, Acoustic Model và Vocoder là mô hình tham chiếu phổ biến trong các nghiên cứu công khai (như các công trình nghiên cứu về multispeaker TTS của Google Research hay mô hình neural codec language model VALL-E của Microsoft Research). Trên thực tế, hệ thống thương mại của Vbee AIVoice được thiết kế và tối ưu hóa riêng biệt để xử lý các đặc thù ngữ âm phức tạp của tiếng Việt (thanh điệu, dấu câu, từ mượn), giúp đảm bảo độ tự nhiên và tròn vành rõ chữ cao nhất.
2. Phân biệt Instant Voice Cloning và Professional Voice Adaptation
Trên thị trường hiện nay, công nghệ nhân bản giọng nói thường được chia thành hai nhóm giải pháp chính dựa trên lượng dữ liệu và cơ chế huấn luyện:
Tiêu chí | Instant Voice Cloning (Nhân bản tức thì / Zero-shot) | Professional Voice Adaptation (Nhân bản chuyên nghiệp) |
Khái niệm | AI trích xuất đặc trưng giọng nói ngay lập tức từ một đoạn audio tham chiếu ngắn mà không cần huấn luyện lại toàn bộ mô hình. | Tinh chỉnh sâu (fine-tuning) mô hình AI dựa trên tập dữ liệu lớn để học trọn vẹn từng sắc thái nhỏ nhất của người nói. |
Dữ liệu đầu vào | Cần ít dữ liệu âm thanh mẫu (từ 10 giây đến vài phút). | Cần dữ liệu âm thanh lớn và đạt chuẩn phòng thu (từ 30 phút đến vài giờ). |
Cơ chế hoạt động | Trích xuất nhanh speaker embedding và ghép trực tiếp vào luồng tạo giọng của mô hình nền tảng. | Cập nhật trọng số của mô hình AI, tạo ra một phiên bản mô hình riêng biệt cho nhân vật đó. |
Chất lượng & Độ giống | Độ giống đạt 80–90%, phụ thuộc rất lớn vào độ sạch của audio mẫu. | Độ giống đạt 95–99%, tái tạo mượt mà ngữ điệu phức tạp và cảm xúc tự nhiên. |
Ứng dụng phù hợp | Creator làm video ngắn, thử nghiệm kịch bản nhanh, làm nội dung tin tức cập nhật liên tục. | Sách nói chuyên nghiệp, trợ lý ảo thương hiệu doanh nghiệp, lồng tiếng phim. |
Nếu bạn cần tạo nhanh một bản sao giọng đọc để làm video ngắn hoặc trải nghiệm, tính năng Instant Voice Cloning (nhân bản nhanh) là lựa chọn tối ưu về mặt thời gian và chi phí. Trong khi đó, các doanh nghiệp xây dựng đại sứ thương hiệu thường chọn giải pháp nhân bản chuyên nghiệp để có chất âm hoàn hảo nhất.
Tham khảo: Quy trình tạo giọng nói cá nhân (Voice Cloning)
3. Các yếu tố quyết định chất lượng giọng AI nhân bản
Dựa trên nguyên lý kỹ thuật và thử nghiệm thực tế, có 5 yếu tố quyết định trực tiếp tới thành công của một giọng nhân bản:
- Chất lượng kỹ thuật của bản thu (Audio Fidelity): Tệp âm thanh cần rõ ràng, âm lượng vừa phải, không bị méo tiếng hay bị nén quá mức khiến dải tần số bị suy giảm.
- Môi trường thu âm (Acoustic Environment): Phòng thu cần triệt tiêu tiếng vang (reverb) và tạp âm nền (tiếng quạt, tiếng xe chạy). Tiếng vang trong không gian hẹp là nguyên nhân hàng đầu khiến giọng AI bị vang và thiếu chân thực.
- Lượng và độ đa dạng của dữ liệu (Data Diversity): Đoạn mẫu thu âm nên bao gồm nhiều kiểu câu khác nhau: câu trần thuật, câu hỏi, câu cảm thán. Điều này giúp acoustic model học được trọn vẹn thang độ cao âm của bạn.
- Cách phát âm và kỹ thuật đọc (Diction & Delivery): Người đọc mẫu cần giữ nhịp đọc ổn định, phát âm rõ từng từ, tránh thói quen ậm ừ hoặc phát âm ngọng dấu thanh.
- Năng lực của mô hình AI (Model Capability): Công nghệ cốt lõi của nền tảng đóng vai trò quyết định. Các nền tảng được tối ưu riêng cho tiếng Việt như Vbee AIVoice sẽ xử lý các từ ghép, thanh điệu (hỏi, ngã, nặng) và cách ngắt nghỉ câu tiếng Việt tự nhiên hơn hẳn các mô hình đa ngôn ngữ chung chung.
4. Quyền sở hữu và tính pháp lý (Consent) khi nhân bản giọng nói
Công nghệ nhân bản giọng nói mở ra cơ hội sáng tạo vô tận, nhưng cũng đòi hỏi trách nhiệm cao về mặt đạo đức và pháp lý. Vbee AIVoice cam kết tuân thủ nghiêm ngặt các tiêu chuẩn an toàn thông tin và bảo vệ bản quyền giọng nói. Người dùng tuyệt đối không được nhân bản giọng nói của người khác khi chưa nhận được sự đồng ý (consent) bằng văn bản hoặc xác thực hợp lệ. Bạn có thể tìm hiểu chi tiết các quy định về an toàn thông tin và quyền riêng tư tại Chính sách bảo mật của Vbee.
5. Câu hỏi thường gặp (FAQ)
5.1 Cần bao nhiêu phút audio để tạo một giọng clone dùng được?
Với công nghệ Instant Voice Cloning trên Vbee AIVoice, bạn chỉ cần một đoạn thu âm sạch kéo dài từ 10 giây đến 3 phút là hệ thống đã có thể trích xuất speaker embedding và khởi tạo giọng đọc AI ổn định.
5.2 Giọng AI nhân bản có thể đọc được tiếng nước ngoài không?
Có. Nhờ sự hỗ trợ của mô hình học máy đa ngôn ngữ, giọng AI nhân bản từ bản thu tiếng Việt của bạn vẫn có thể cất lời bằng tiếng Anh hoặc các ngôn ngữ khác mà vẫn giữ nguyên âm sắc cá nhân đặc trưng.
5.3 Nên sử dụng thiết bị gì và thu âm thời lượng bao lâu để có giọng clone tối ưu?
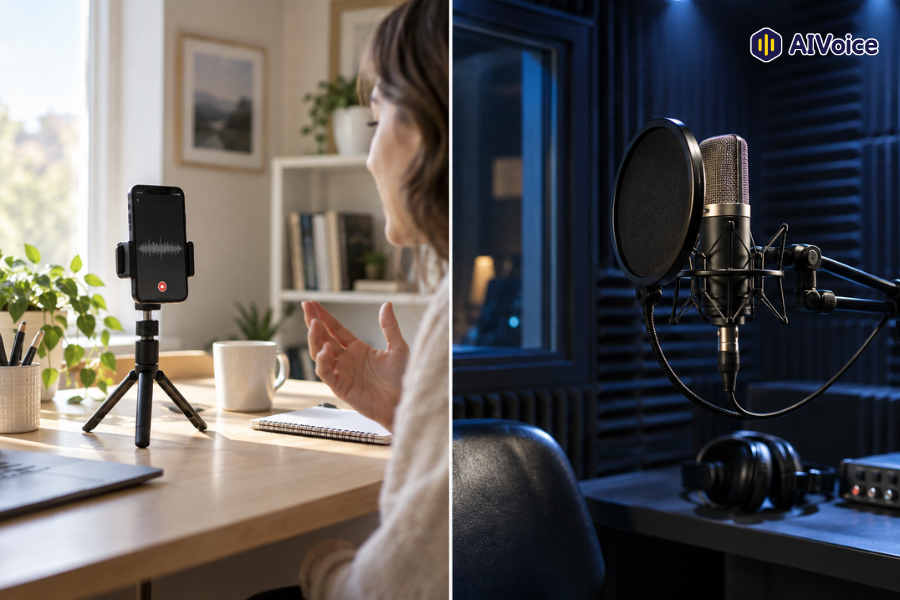
Bạn có thể sử dụng micro thu âm chuyên dụng hoặc điện thoại thông minh đặt cách miệng 15 - 20cm. Thời lượng thu từ 1 đến 3 phút với nội dung đọc rõ từ, tốc độ vừa phải sẽ giúp AI trích xuất đặc trưng giọng một cách trọn vẹn nhất.
Hiểu rõ voice cloning hoạt động như thế nào giúp bạn chủ động hơn trong việc chuẩn bị nguyên liệu đầu vào, từ đó khai thác tối đa sức mạnh của AI trong sáng tạo nội dung. Từ việc trích xuất “dấu vân tay giọng nói” (speaker embedding) đến việc tái tạo sóng âm qua vocoder, mỗi bước đều đóng vai trò quan trọng tạo nên một giọng đọc truyền cảm.
